LIBREOFFICE · ПРАКТИКА
Анализ данных, в котором можно проверить выводы
Надёжный анализ начинается с проверки исходной таблицы. Узнайте, как отличать пропуски от нулей, сравнивать группы и связывать выводы с конкретными показателями.
Попробовать СВОЯ ЗАДАЧА. ПОНЯТНЫЙ РЕЗУЛЬТАТ.
01 / РАЗБЕРЁМСЯ В ДЕТАЛЯХ
Проверка качества предшествует сводке
Перед анализом выберите числовой показатель и проверьте его тип во всех строках. Пустое значение не равно нулю; текст вместо числа может исказить итог. Сначала разберите такие записи, затем переходите к агрегатам.
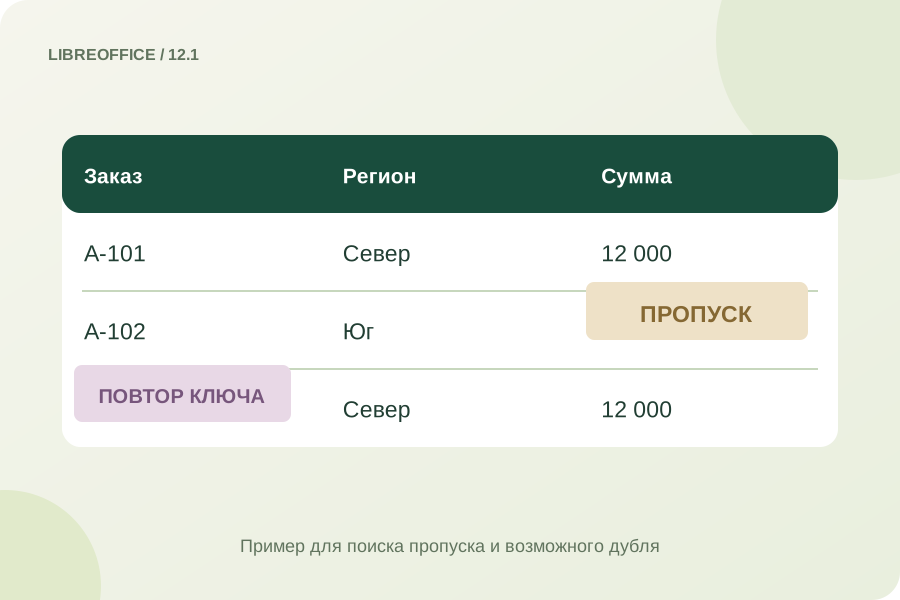
Пропуски и повторяющиеся строки требуют разных решений. Пустая ячейка не означает нулевой заказ, а совпадающие записи не всегда являются ошибкой. До удаления нужно определить, что представляет одна строка и какой ключ делает её уникальной.
Не меняйте исходные данные без понятного правила.
02 / РАЗБЕРЁМСЯ В ДЕТАЛЯХ
Сводка по категориям должна сходиться с итогом
Решите, что означает одна строка: заказ, позиция заказа или клиент. Проверка полных дублей сравнивает все ячейки; проверка по ключу — выбранный столбец. Повтор ключа может быть законным, поэтому строки не удаляются автоматически. Любое исключение должно иметь понятную причину.
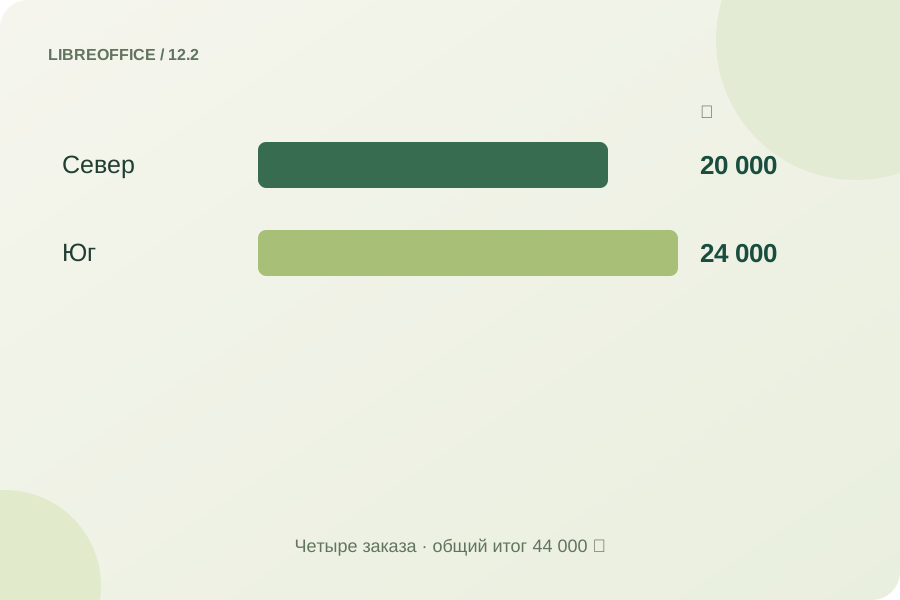
После группировки удобно проверить общий итог по исходным строкам и по сводке. Если значения расходятся, сначала сравнивают фильтры, пропуски и типы данных. В примере сумма заказов Юга выше на 4 000 рублей, но это ещё не объяснение причины.
Один набор строк должен давать согласованные итоги.
03 / РАЗБЕРЁМСЯ В ДЕТАЛЯХ
Среднее и медиана смотрят на выборку по-разному
Сводку по категориям строят из одного и того же набора наблюдений с понятным фильтром. Категории без названия проверяют отдельно. В учебных заказах Юг даёт 24 000 рублей, Север — 20 000, общий итог — 44 000 рублей.
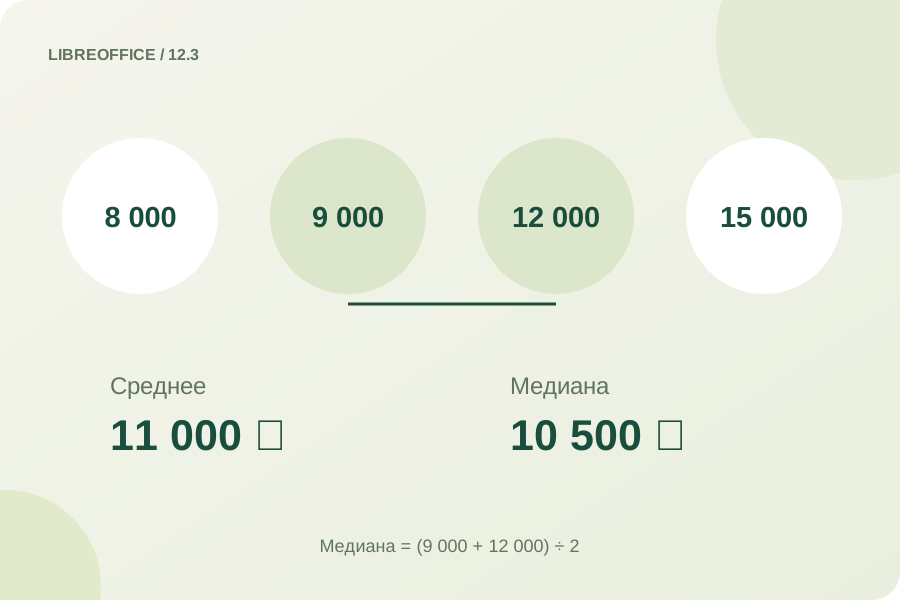
Среднее делит сумму на число заполненных наблюдений. Медиана показывает середину отсортированного ряда и меньше зависит от отдельных крупных значений. Смотрите оба показателя вместе с размером выборки: одно большое наблюдение может заметно сместить среднее.
Таблица сообщает, что произошло в наборе данных, но не доказывает причины. Большая сумма заказов региона ещё не означает лучшую работу менеджера: могли отличаться число клиентов, ассортимент и период. Подпишите фильтр и период рядом с выгруженным отчётом.
Один крупный заказ может заметно поднять среднее. Медиана остаётся серединой отсортированного ряда и помогает увидеть другую сторону распределения. Ни один из показателей не стоит читать без числа наблюдений и понимания периода.
Число наблюдений и распределение важны не меньше среднего.
УЧЕБНЫЙ ПРИМЕР
Проверьте ход решения
Вымышленные заказы: Север — 12 000 и 8 000 ₽; Юг — 9 000 и 15 000 ₽. Итого 44 000 ₽, Юг 24 000 ₽, Север 20 000 ₽. Верный вывод: сумма заказов Юга выше на 4 000 ₽; нельзя заключать, что менеджер эффективнее, не учитывая число клиентов и условия продаж.
Условные данные для демонстрации метода.ВОПРОСЫ И ОТВЕТЫ
Полезно знать
Можно удалить все одинаковые строки?
Не всегда: сначала определите ключ и выясните, могут ли совпадающие строки быть самостоятельными операциями.
Почему среднее меняется после одного большого заказа?
Среднее чувствительно к выбросам; дополнительно посмотрите медиану и распределение.
Пустая ячейка равна нулю?
Нет: отсутствие значения и нулевой показатель имеют разный смысл и требуют явного правила обработки.
Что должно подтверждать текстовый вывод?
Показатель, фильтр, период и исходные данные, из которых он рассчитан.
ГОТОВЫ ПЕРЕЙТИ К ПРАКТИКЕ?